AI與數據庫深度融合 阿里云PolarDB發布AI數據湖庫,引領數據庫服務新范式
隨著人工智能技術的飛速發展,特別是大語言模型(LLM)的爆發式演進,AI正從獨立的應用工具,轉變為驅動各行各業底層基礎設施升級的核心引擎。在這一趨勢下,數據庫作為數據存儲、管理和分析的基石,其與AI的深度融合已成為必然。阿里云在數據庫領域邁出關鍵一步,宣布在其核心產品PolarDB中發布“AI數據湖庫”等創新服務,標志著將AI大模型能力深度嵌入數據庫系統的實踐進入新階段,旨在重塑數據處理與分析的全流程。
一、 核心理念:從“數據庫存數據”到“數據庫懂數據”
傳統數據庫的核心職責是高效、可靠地“存儲”與“查詢”結構化數據。在非結構化數據(如文本、圖像、音視頻)占比超過80%的今天,僅靠傳統的SQL查詢已難以挖掘數據的深層價值。阿里云PolarDB推出的AI數據湖庫,其核心在于將AI大模型的感知、理解和生成能力,內化為數據庫的“原生能力”。這實現了兩大轉變:
- 智能數據處理:數據庫不僅能存儲非結構化數據,更能自動理解其內容。例如,存入一段客服錄音,數據庫可自動調用內置的語音識別和情感分析模型,將音頻轉為文本并提取關鍵信息和客戶情緒標簽,供后續高效查詢分析。
- 自然語言交互:用戶可以直接使用自然語言向數據庫提問,例如“找出上周所有對物流速度不滿的客戶反饋摘要”。AI數據湖庫能自動解析意圖,將其轉化為對多模態數據的復雜查詢與分析操作,并將結果以直觀的報告或摘要形式呈現,極大降低了數據使用的技術門檻。
二、 阿里云PolarDB AI數據湖庫的關鍵能力
此次發布并非簡單的功能疊加,而是架構層面的深度集成:
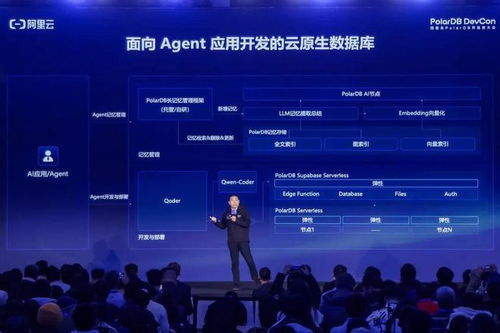
- 內置AI模型框架:PolarDB AI數據湖庫內置了模型管理與調度框架,支持集成阿里云自研的通義千問等大模型以及第三方開源模型。用戶無需在數據庫和AI平臺間頻繁遷移數據,可在數據庫內一站式完成數據的預處理、模型調用與推理。
- 統一的數據湖倉能力:它提供了統一的數據湖倉一體的存儲底座,既能高效處理海量非結構化原始數據(湖),也支持將其處理、分析后的高價值結構化結果同步至高性能數倉(倉),實現數據在“湖”與“倉”之間的智能流動與閉環。
- 向量引擎與智能檢索:深度集成高性能向量引擎,可將文本、圖像等內容轉化為向量嵌入(Embedding)進行存儲。這使得數據庫具備強大的語義檢索和相似性搜索能力,例如在商品庫中“尋找與這張圖片風格類似的家具”,實現基于內容理解的精準推薦。
- 企業級安全與治理:所有AI處理過程均在數據庫的安全邊界內完成,數據無需出域,保障了數據隱私與合規性。提供完整的AI任務生命周期管理和數據血緣追蹤,確保AI分析過程的可靠與可審計。
三、 應用場景與行業價值
這種“AI原生”的數據庫服務將深刻改變多個行業的數據應用模式:
- 金融風控與投研:自動解析海量財報、新聞、輿情中的關鍵信息,實時關聯結構化交易數據,智能生成風險預警或投資洞察報告。
- 智能媒體與內容管理:自動為圖片、視頻庫生成標簽、描述和摘要,實現基于內容的智能編目與快速檢索,提升內容創作與分發效率。
- 制造業與物聯網:在時序數據庫中直接分析設備傳感器數據與維修日志文本,預測設備故障并自動生成維修建議。
- 客戶服務與營銷:一站式分析客戶的結構化交易記錄與非結構化的對話、評價,構建360度客戶視圖,驅動個性化服務與營銷策略。
四、 展望:數據庫服務的未來范式
阿里云PolarDB此次創新,是云數據庫向“AI-Native”演進的一個重要信號。數據庫將不再是一個被動的數據容器,而是一個具備“認知”能力的主動智能體。其發展趨勢可能包括:
- 更強大的自治能力:數據庫能根據數據特征和訪問模式,自動優化索引、調整存儲結構,甚至預測性能瓶頸并進行自我調優。
- 更廣泛的多模態融合:深度融合文本、語音、視覺乃至3D模型的處理能力,成為企業多模態數據智能的統一中樞。
- 更普惠的開發者體驗:通過自然語言交互和自動化的AI分析流水線,使數據分析師、業務人員乃至普通用戶都能直接與數據對話,釋放全民數據潛能。
將AI大模型嵌入數據庫,特別是通過像阿里云PolarDB AI數據湖庫這樣的服務實現深度集成,正在打破數據處理與智能分析之間的壁壘。這不僅是技術的升級,更是思維模式的變革,預示著以數據驅動為核心的企業,其運營和決策方式將迎來新一輪的智能化革命。
如若轉載,請注明出處:http://www.638e.cn/product/19.html
更新時間:2026-11-11 01:36:07